BLACKWELL ULTRAB300
288 GB / GPU
NVIDIA ACCELERATED COMPUTING
B300, B200, H200 и H100: архитектура, память, применение и требования к инфраструктуре.
Подобрать платформу288 GB / GPU
180 GB / GPU
141 GB / GPU
80 GB / GPU
MULTI-GPU PLATFORM
HGX — базовая multi-GPU платформа для серверов AI и HPC. Восемь ускорителей работают как связанный вычислительный узел благодаря NVLink и NVSwitch.
GPU обмениваются данными по NVLink через NVSwitch без выхода в межсерверную сеть.
Тензоры и параметры модели распределяются между ускорителями внутри платформы.
Несколько HGX-серверов связываются InfiniBand или высокоскоростным Ethernet.
ARCHITECTURE
Blackwell не является автоматическим выбором для каждого проекта. Важны модель, память, бюджет, сеть, питание и охлаждение.
B300 · B200
H200 · H100
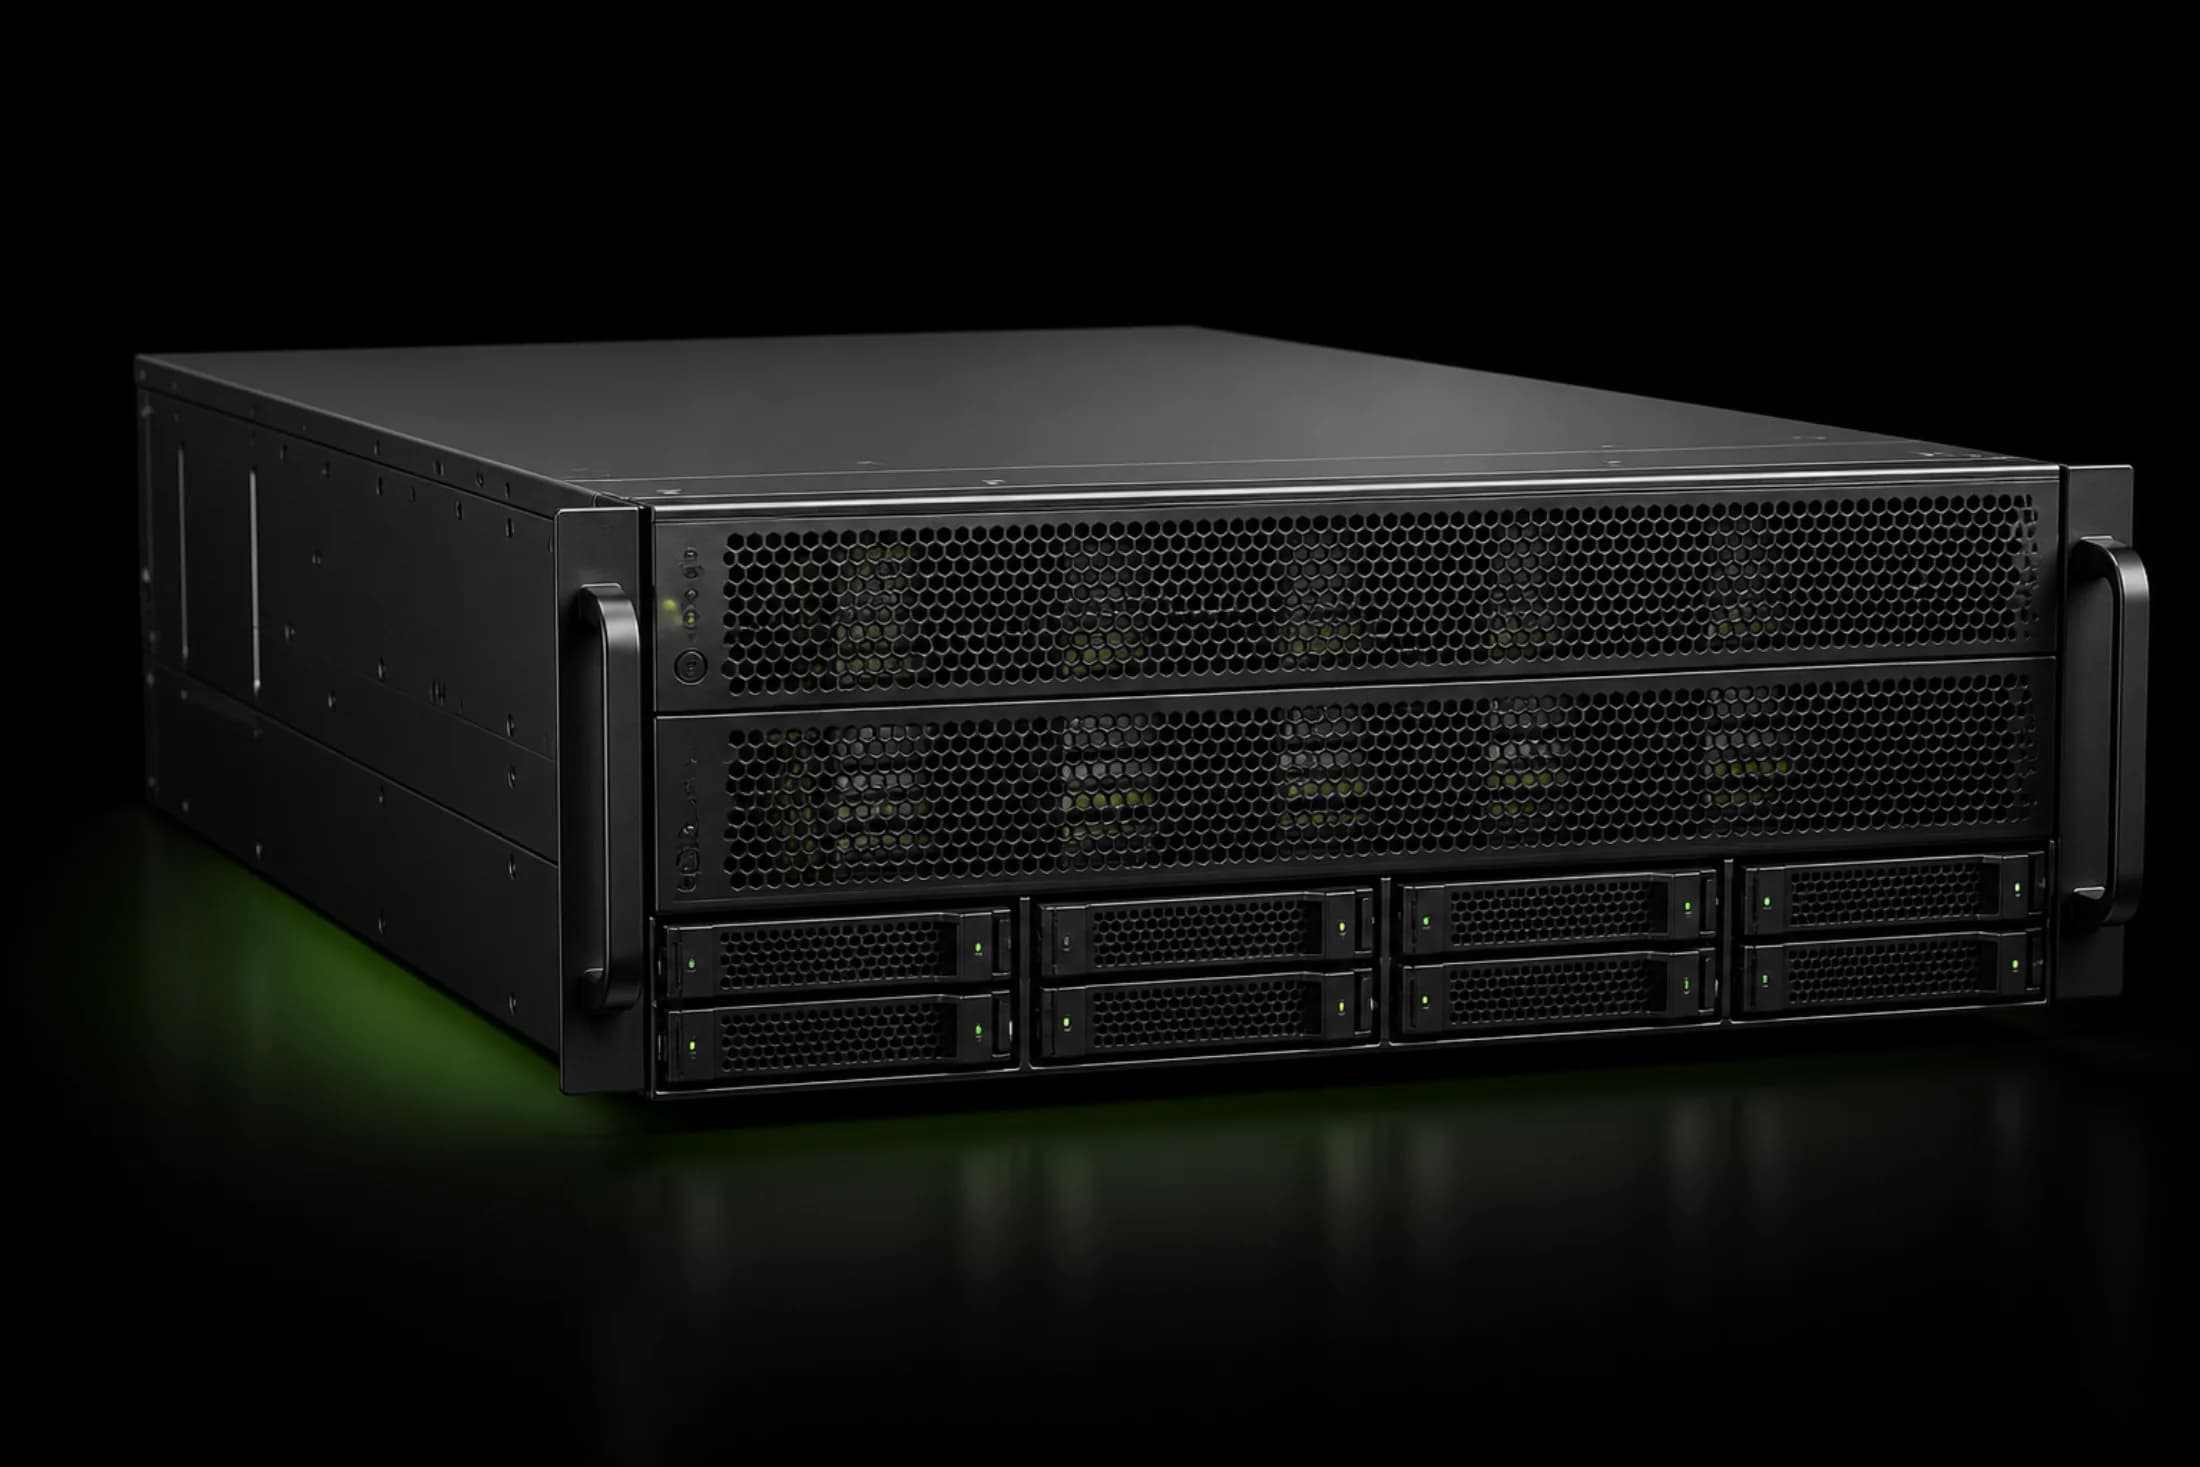
01 / BLACKWELL ULTRA
Высокоплотная платформа для крупных LLM, reasoning-моделей, AI Factory и memory-intensive inference.
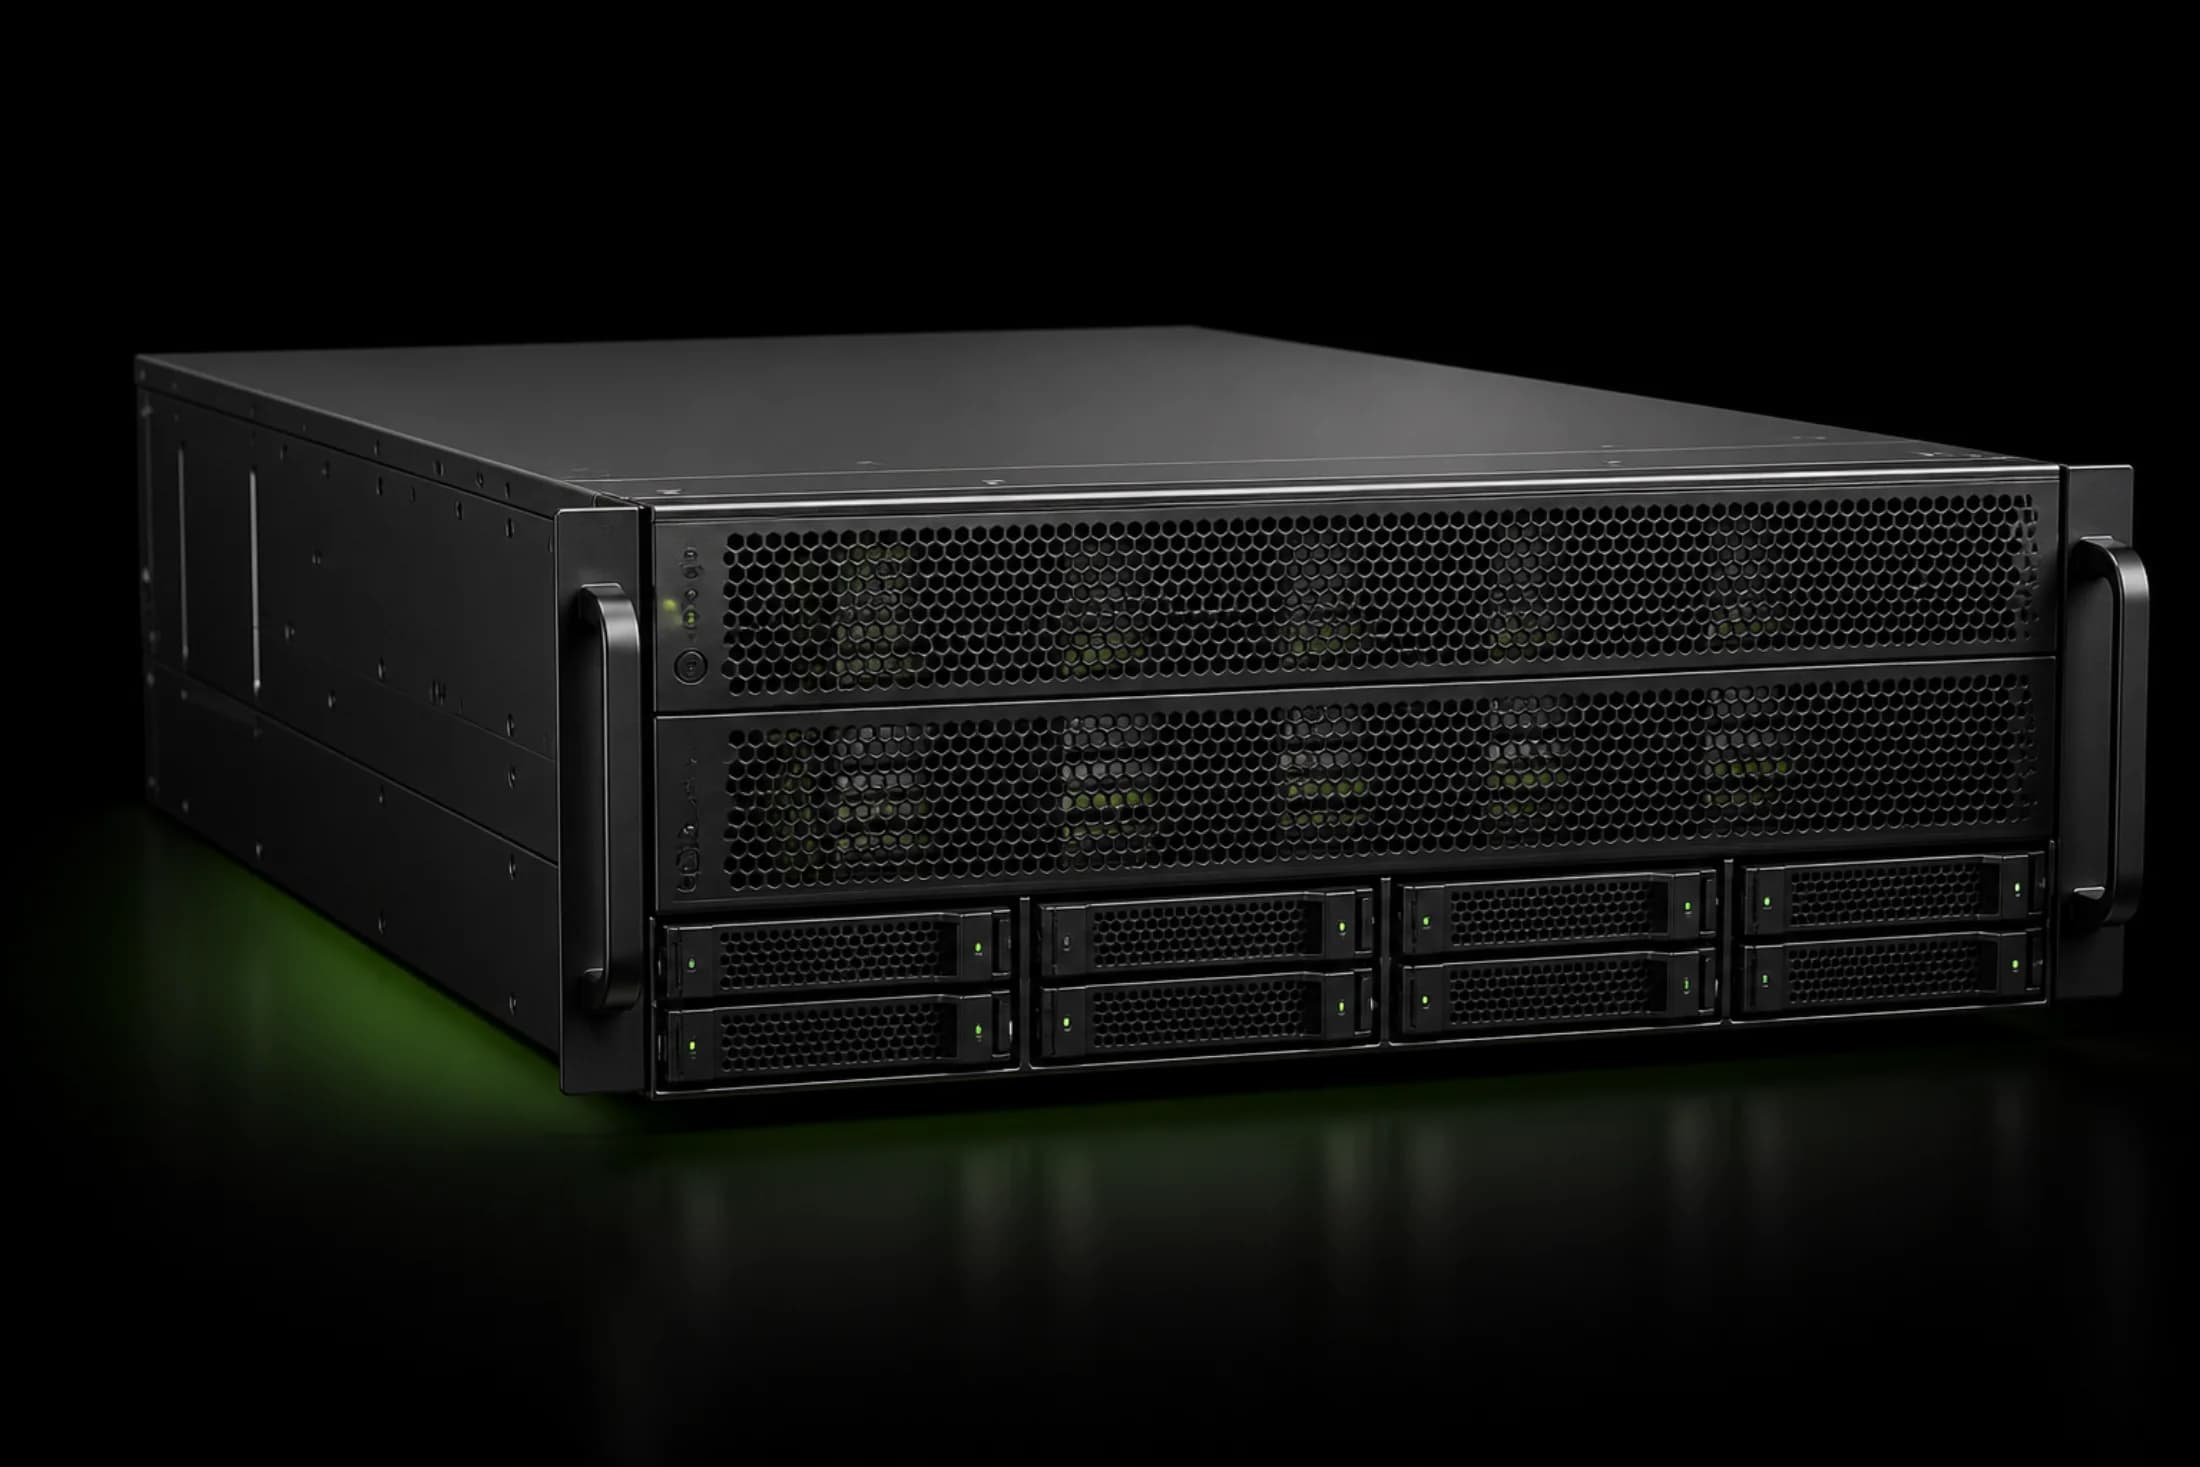
02 / BLACKWELL
Платформа Blackwell для обучения LLM, fine-tuning, GenAI и производительного enterprise inference.
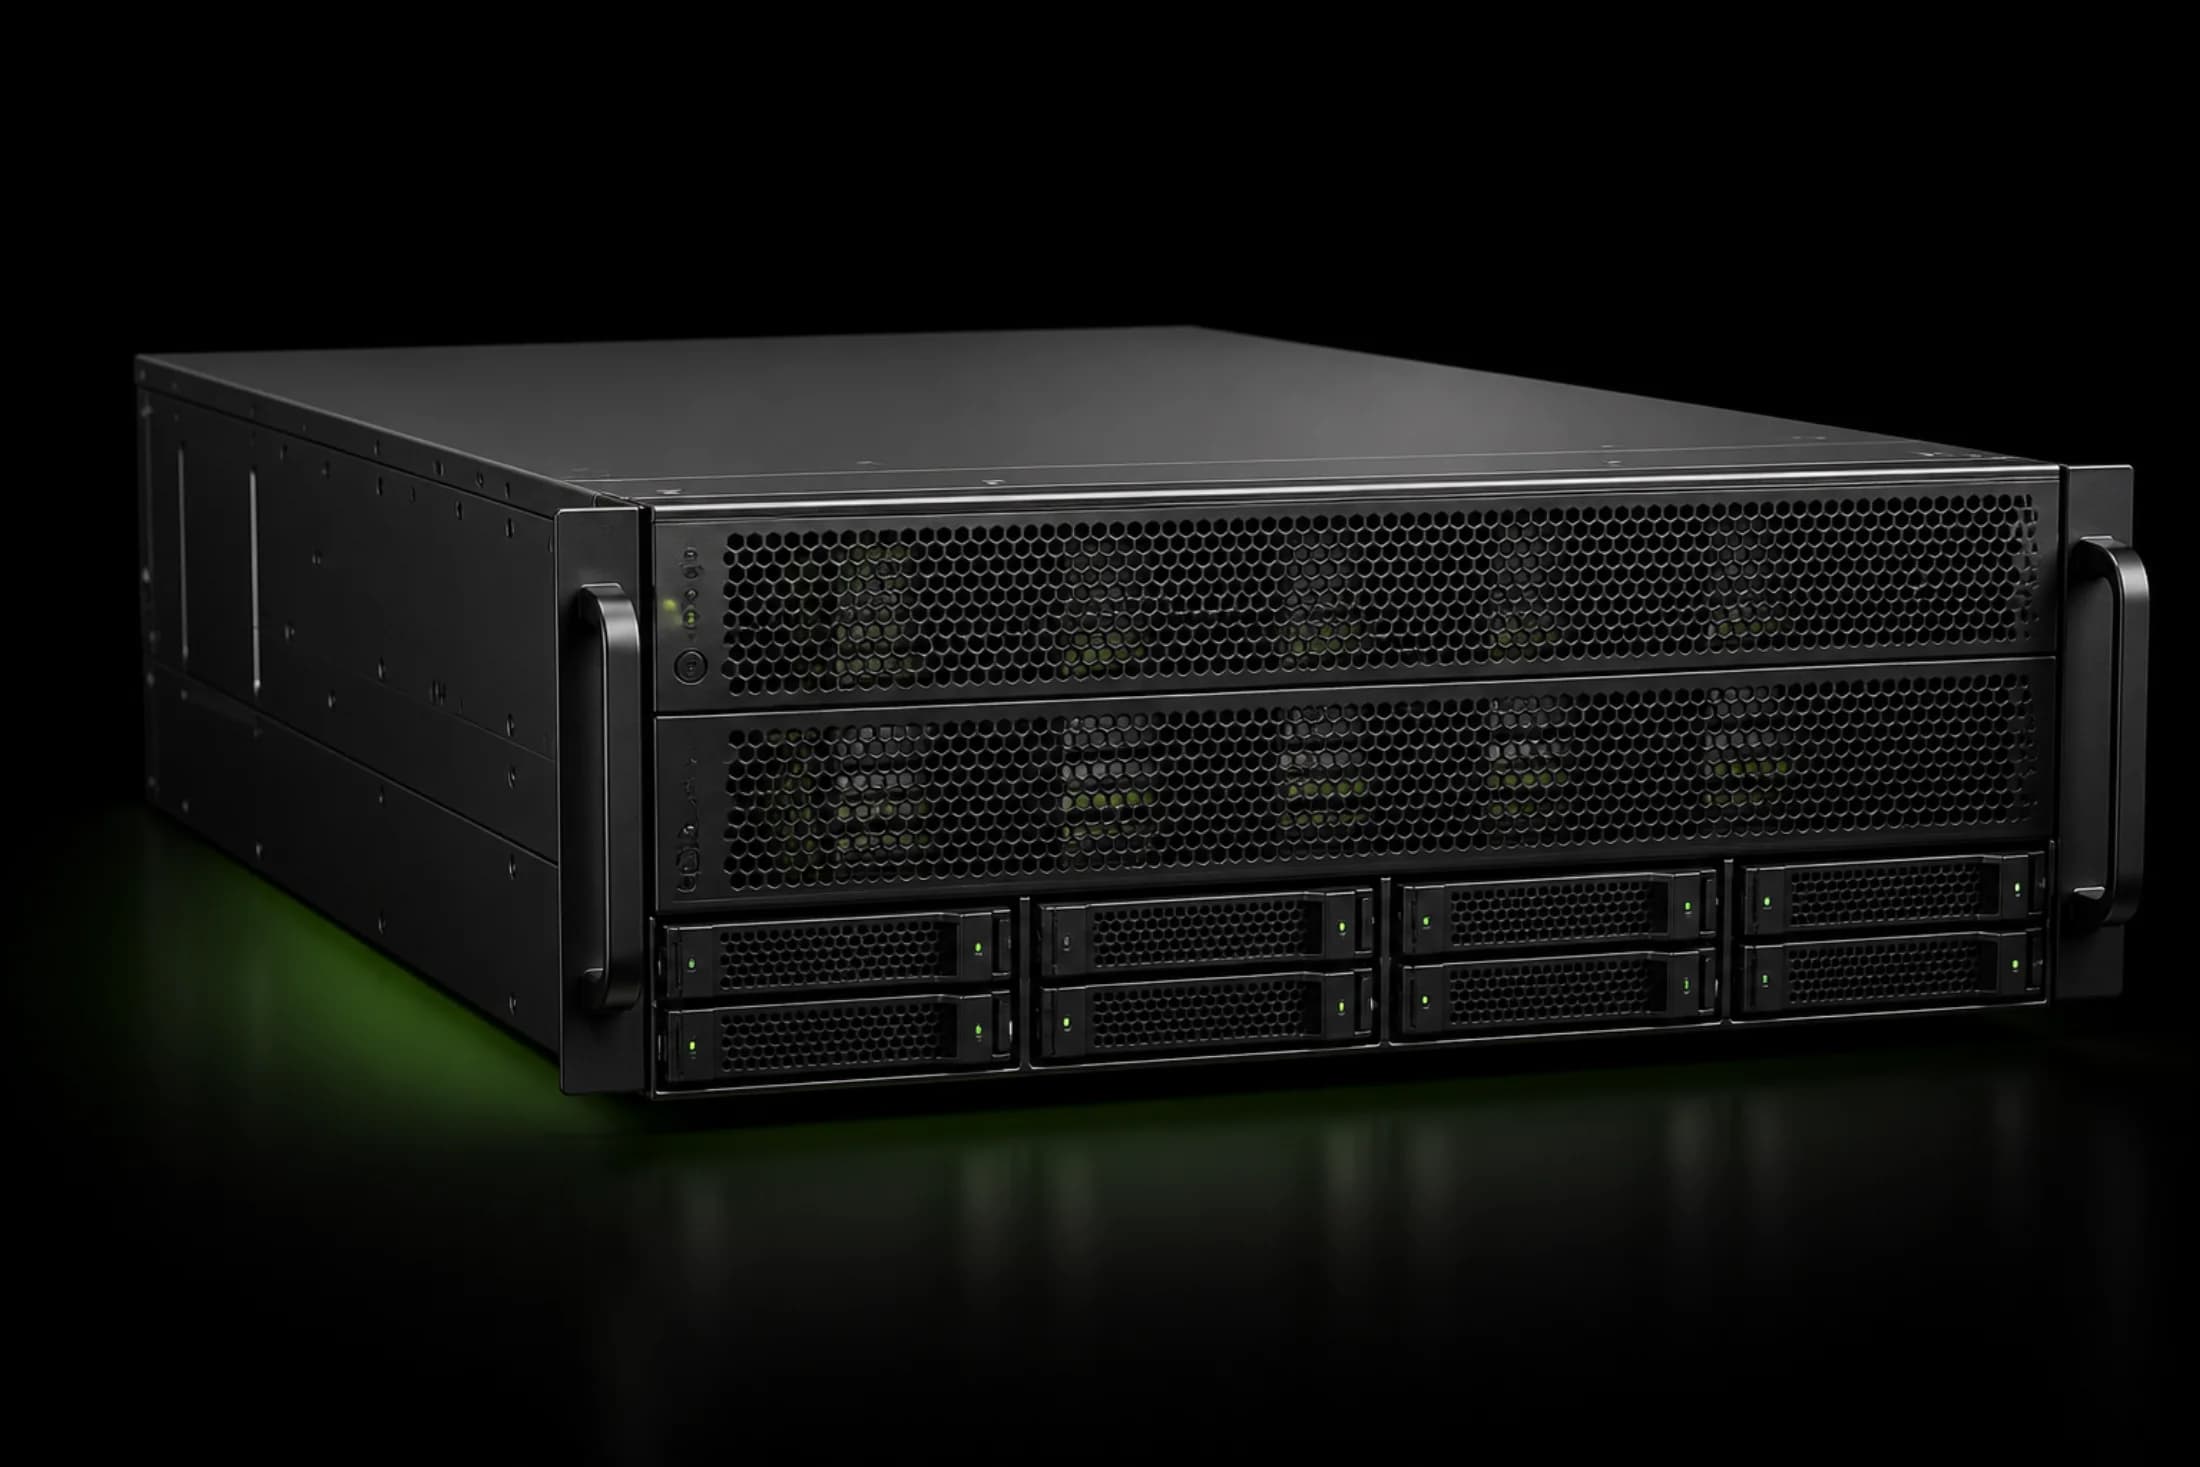
03 / HOPPER
Hopper-платформа с увеличенной HBM3e-памятью для LLM, production inference и HPC.
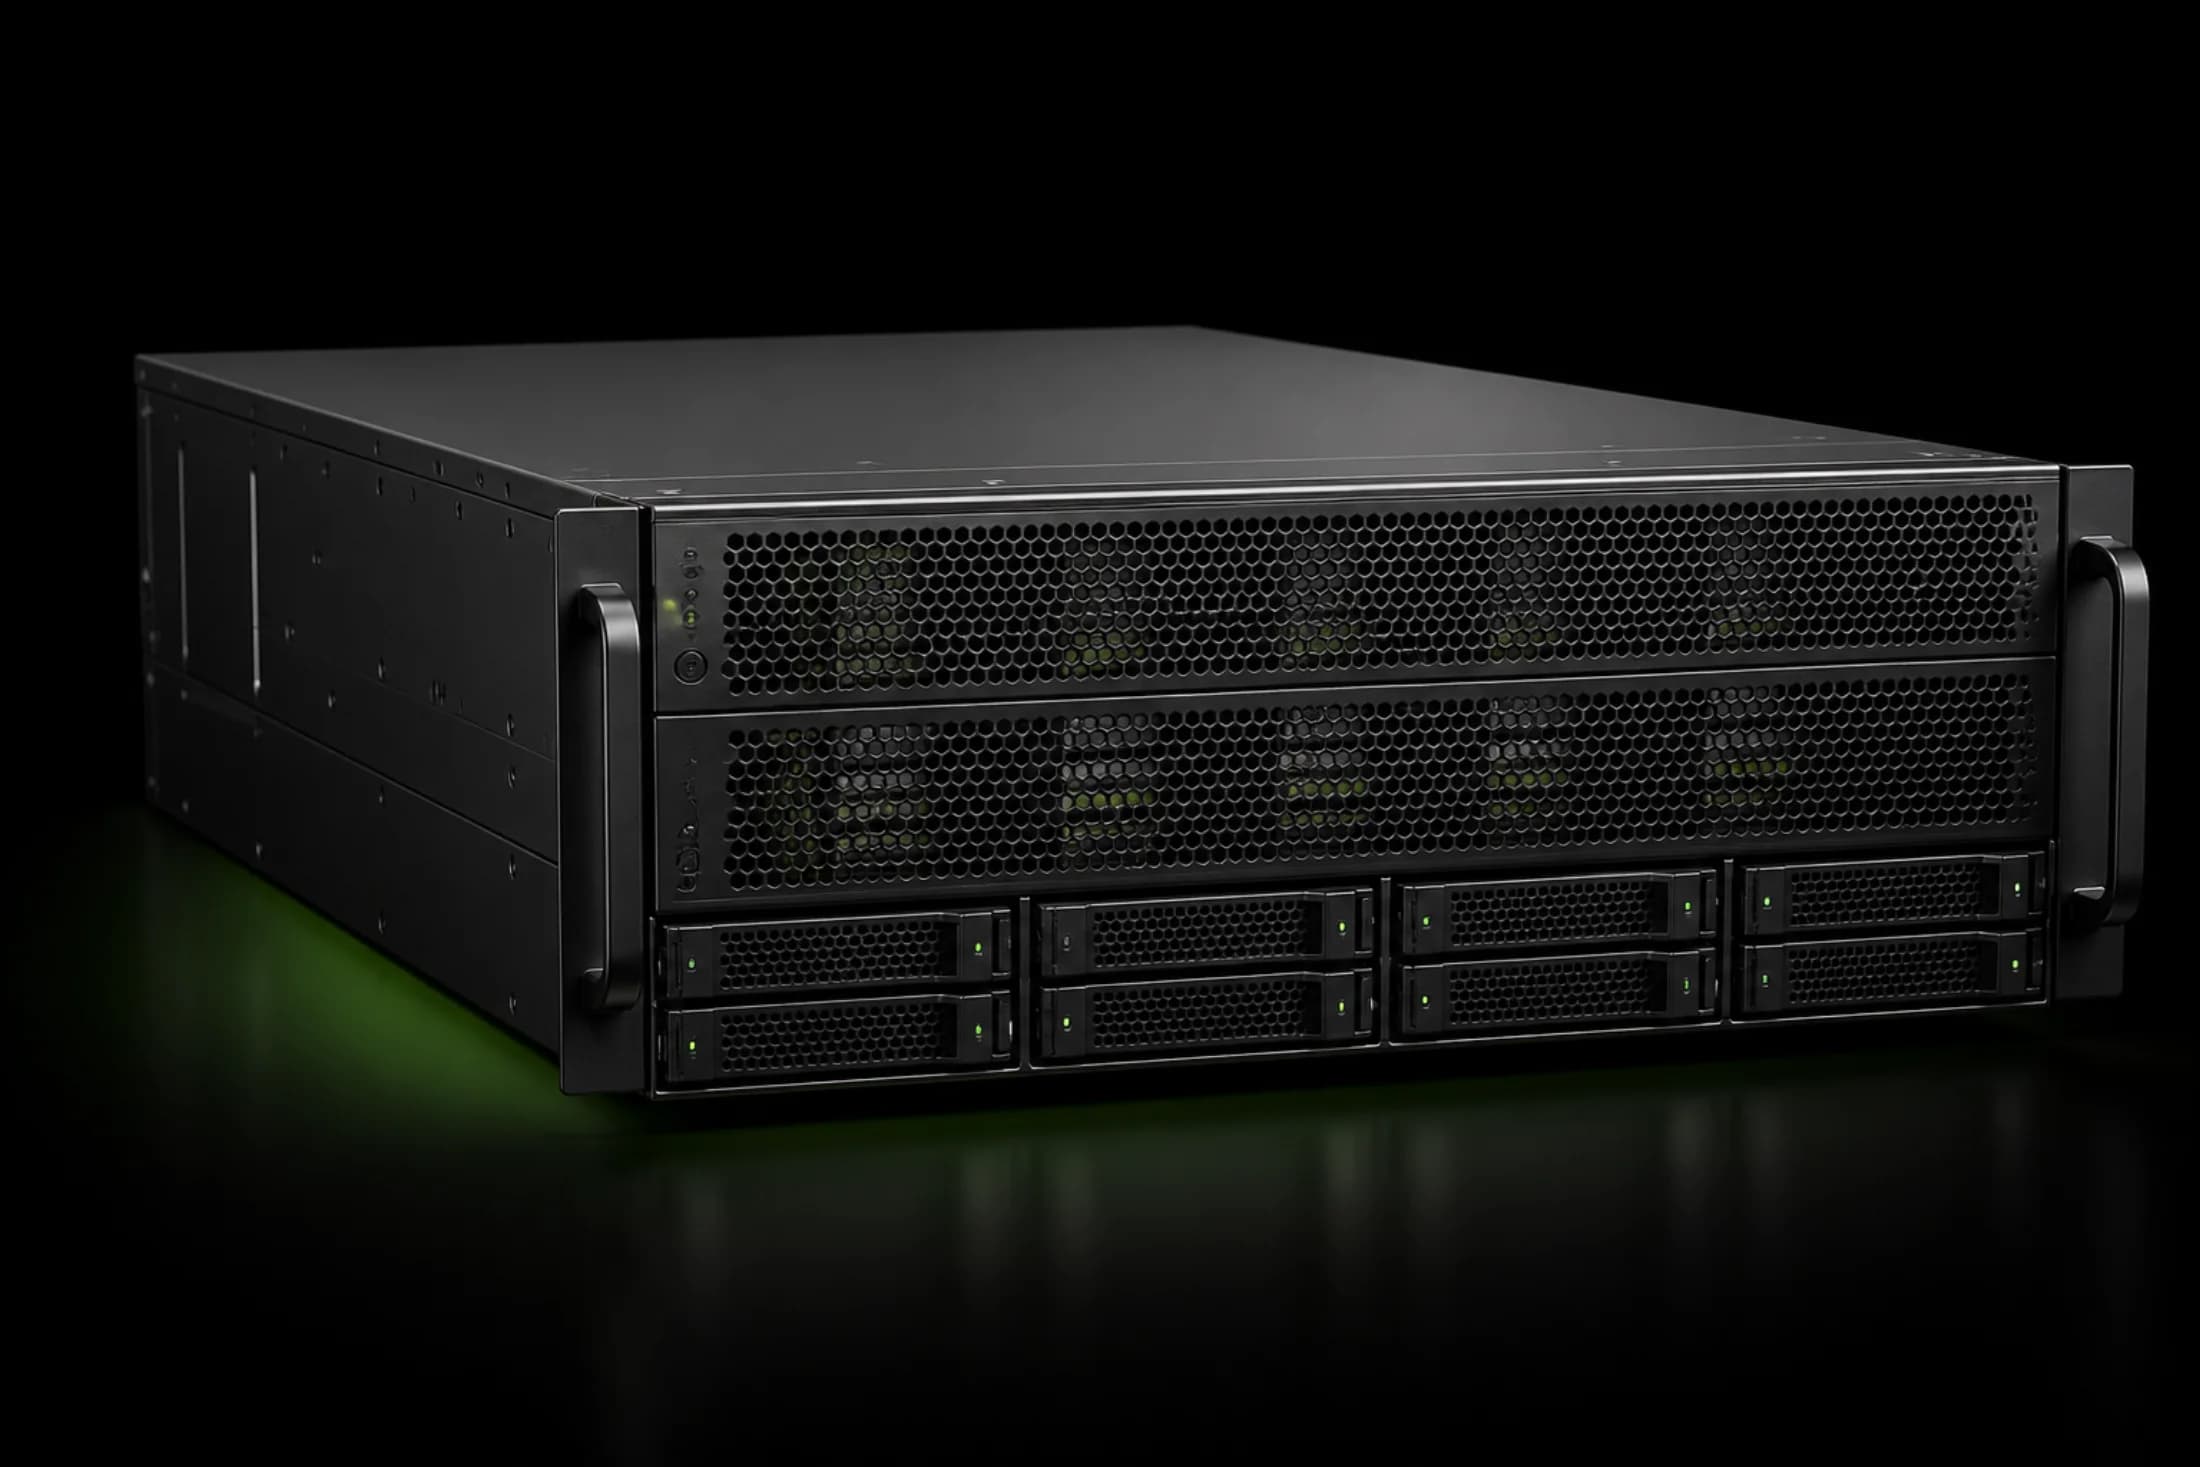
04 / HOPPER
Зрелая production-платформа для обучения, inference, HPC и корпоративных AI-систем.
QUICK SELECTOR
Четыре вопроса помогут определить стартовую платформу для обсуждения с инженером.
BEYOND GPU
Мощность стойки, PDU и резервирование.
Air cooling или Direct Liquid Cooling.
InfiniBand / Ethernet и topology.
Dataset throughput и checkpoints.
Размер, вес, PDU и cabling.
ENGINEER CHECKLIST
Необязательно знать всё. Любые исходные данные ускорят подбор — остальное уточним вместе.
Отправить задачуFAQ
Коротко о выборе архитектуры, сети, масштабировании и подготовке проекта.
HGX — серверная multi-GPU платформа: GPU объединены высокоскоростными NVLink и NVSwitch. Она рассчитана на задачи, где модель или вычисление распределяется между несколькими ускорителями внутри одного узла.
B300 даёт больше памяти на GPU и подходит для особенно крупных моделей, reasoning и memory-intensive inference. B200 — сильная Blackwell-платформа для обучения, fine-tuning и GenAI. Итоговый выбор зависит от модели, режима работы и инфраструктурных ограничений.
H200 полезен там, где критичен объём GPU-памяти: LLM inference, длинный контекст, крупные батчи и HPC-задачи с интенсивным обменом с памятью.
Да. H100 остаётся зрелой production-платформой с широкой программной экосистемой для обучения, inference и HPC. Она может быть рациональным выбором по доступности, бюджету и требованиям workload.
Можно, если заранее заложить сетевую архитектуру, схему хранения, питание и охлаждение. На этапе первого узла важно проверить будущую topology и возможности масштабирования.
Нужно знать объём межузлового обмена, число серверов и характер workload. После этого выбирают InfiniBand или Ethernet, пропускную способность, адаптеры ConnectX, коммутаторы и topology.
Это зависит от конкретной серверной платформы, плотности стойки и возможностей ЦОД. Для части высокоплотных конфигураций применяется Direct Liquid Cooling; требования нужно сверять с выбранной системой.
Достаточно описать модель и сценарий, training или inference, желаемое число GPU, объём данных, сроки и известные ограничения по сети, питанию и охлаждению. Недостающие параметры поможет уточнить инженер.
REQUEST FOR PROPOSAL
Опишите workload — предложим конфигурацию на B300, B200, H200 или H100 и учтём требования к сети, СХД и ЦОД.