server-go / AI INFRASTRUCTURE

GPU-серверы NVIDIA B300, B200, H200 и H100

Высокопроизводительные серверы для обучения LLM, инференса, RAG, Computer Vision и HPC.

  • NVIDIA HGX
  • 4–8 GPU
  • NVLink / NVSwitch
  • Enterprise AI
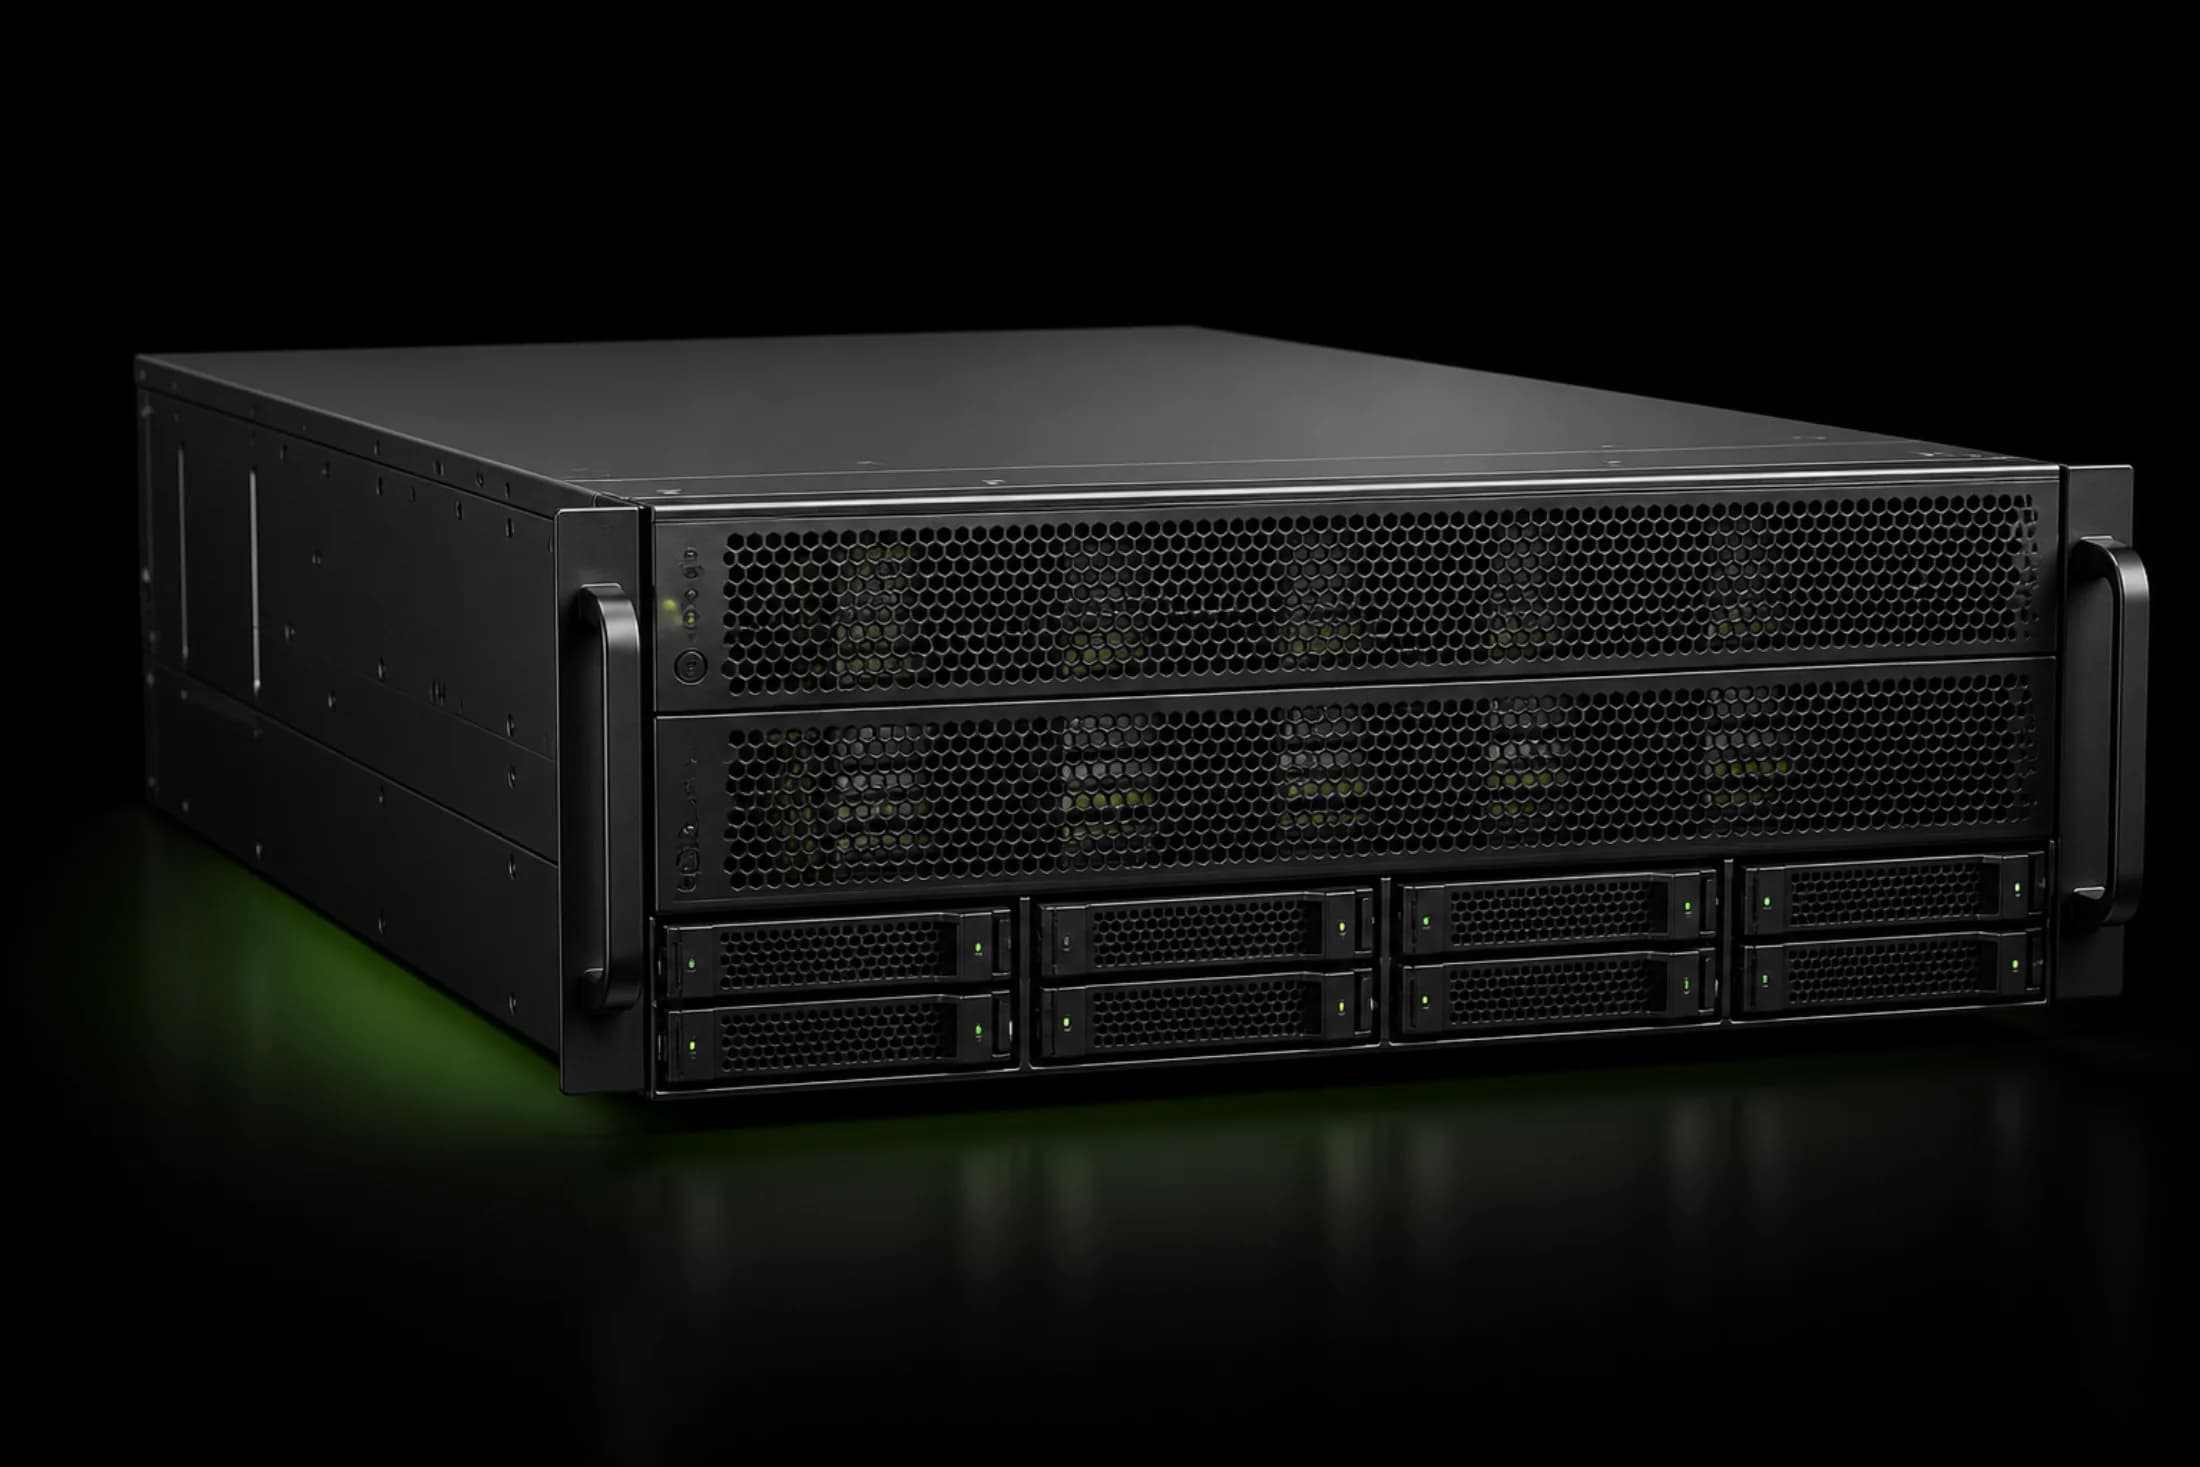
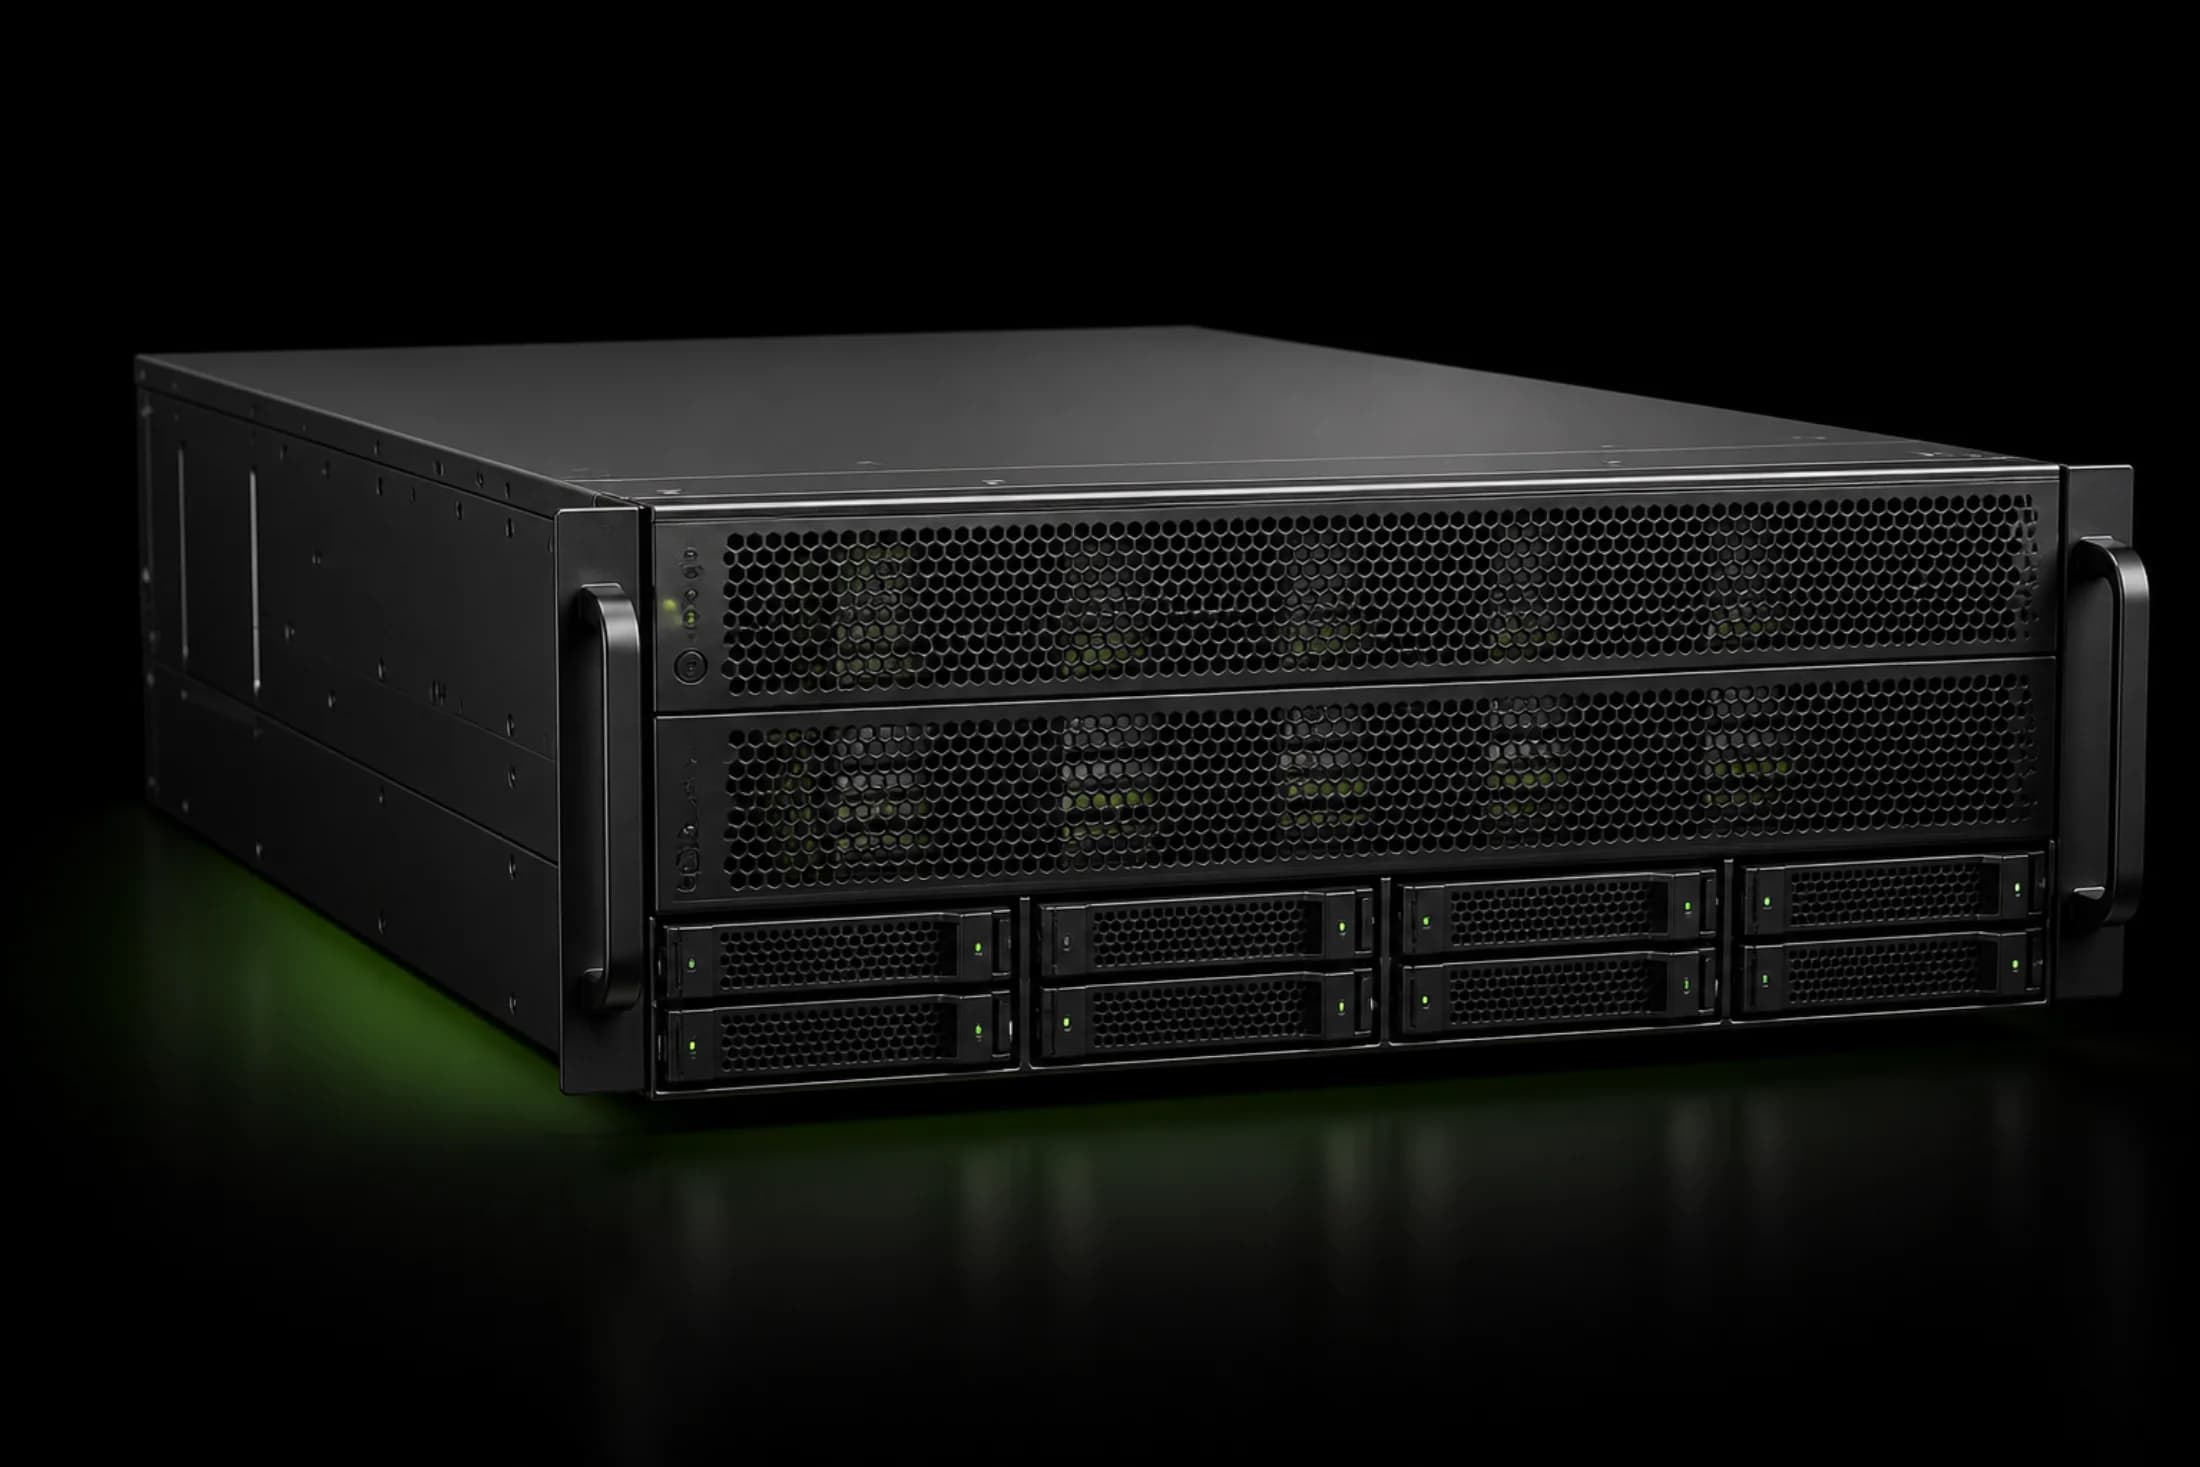
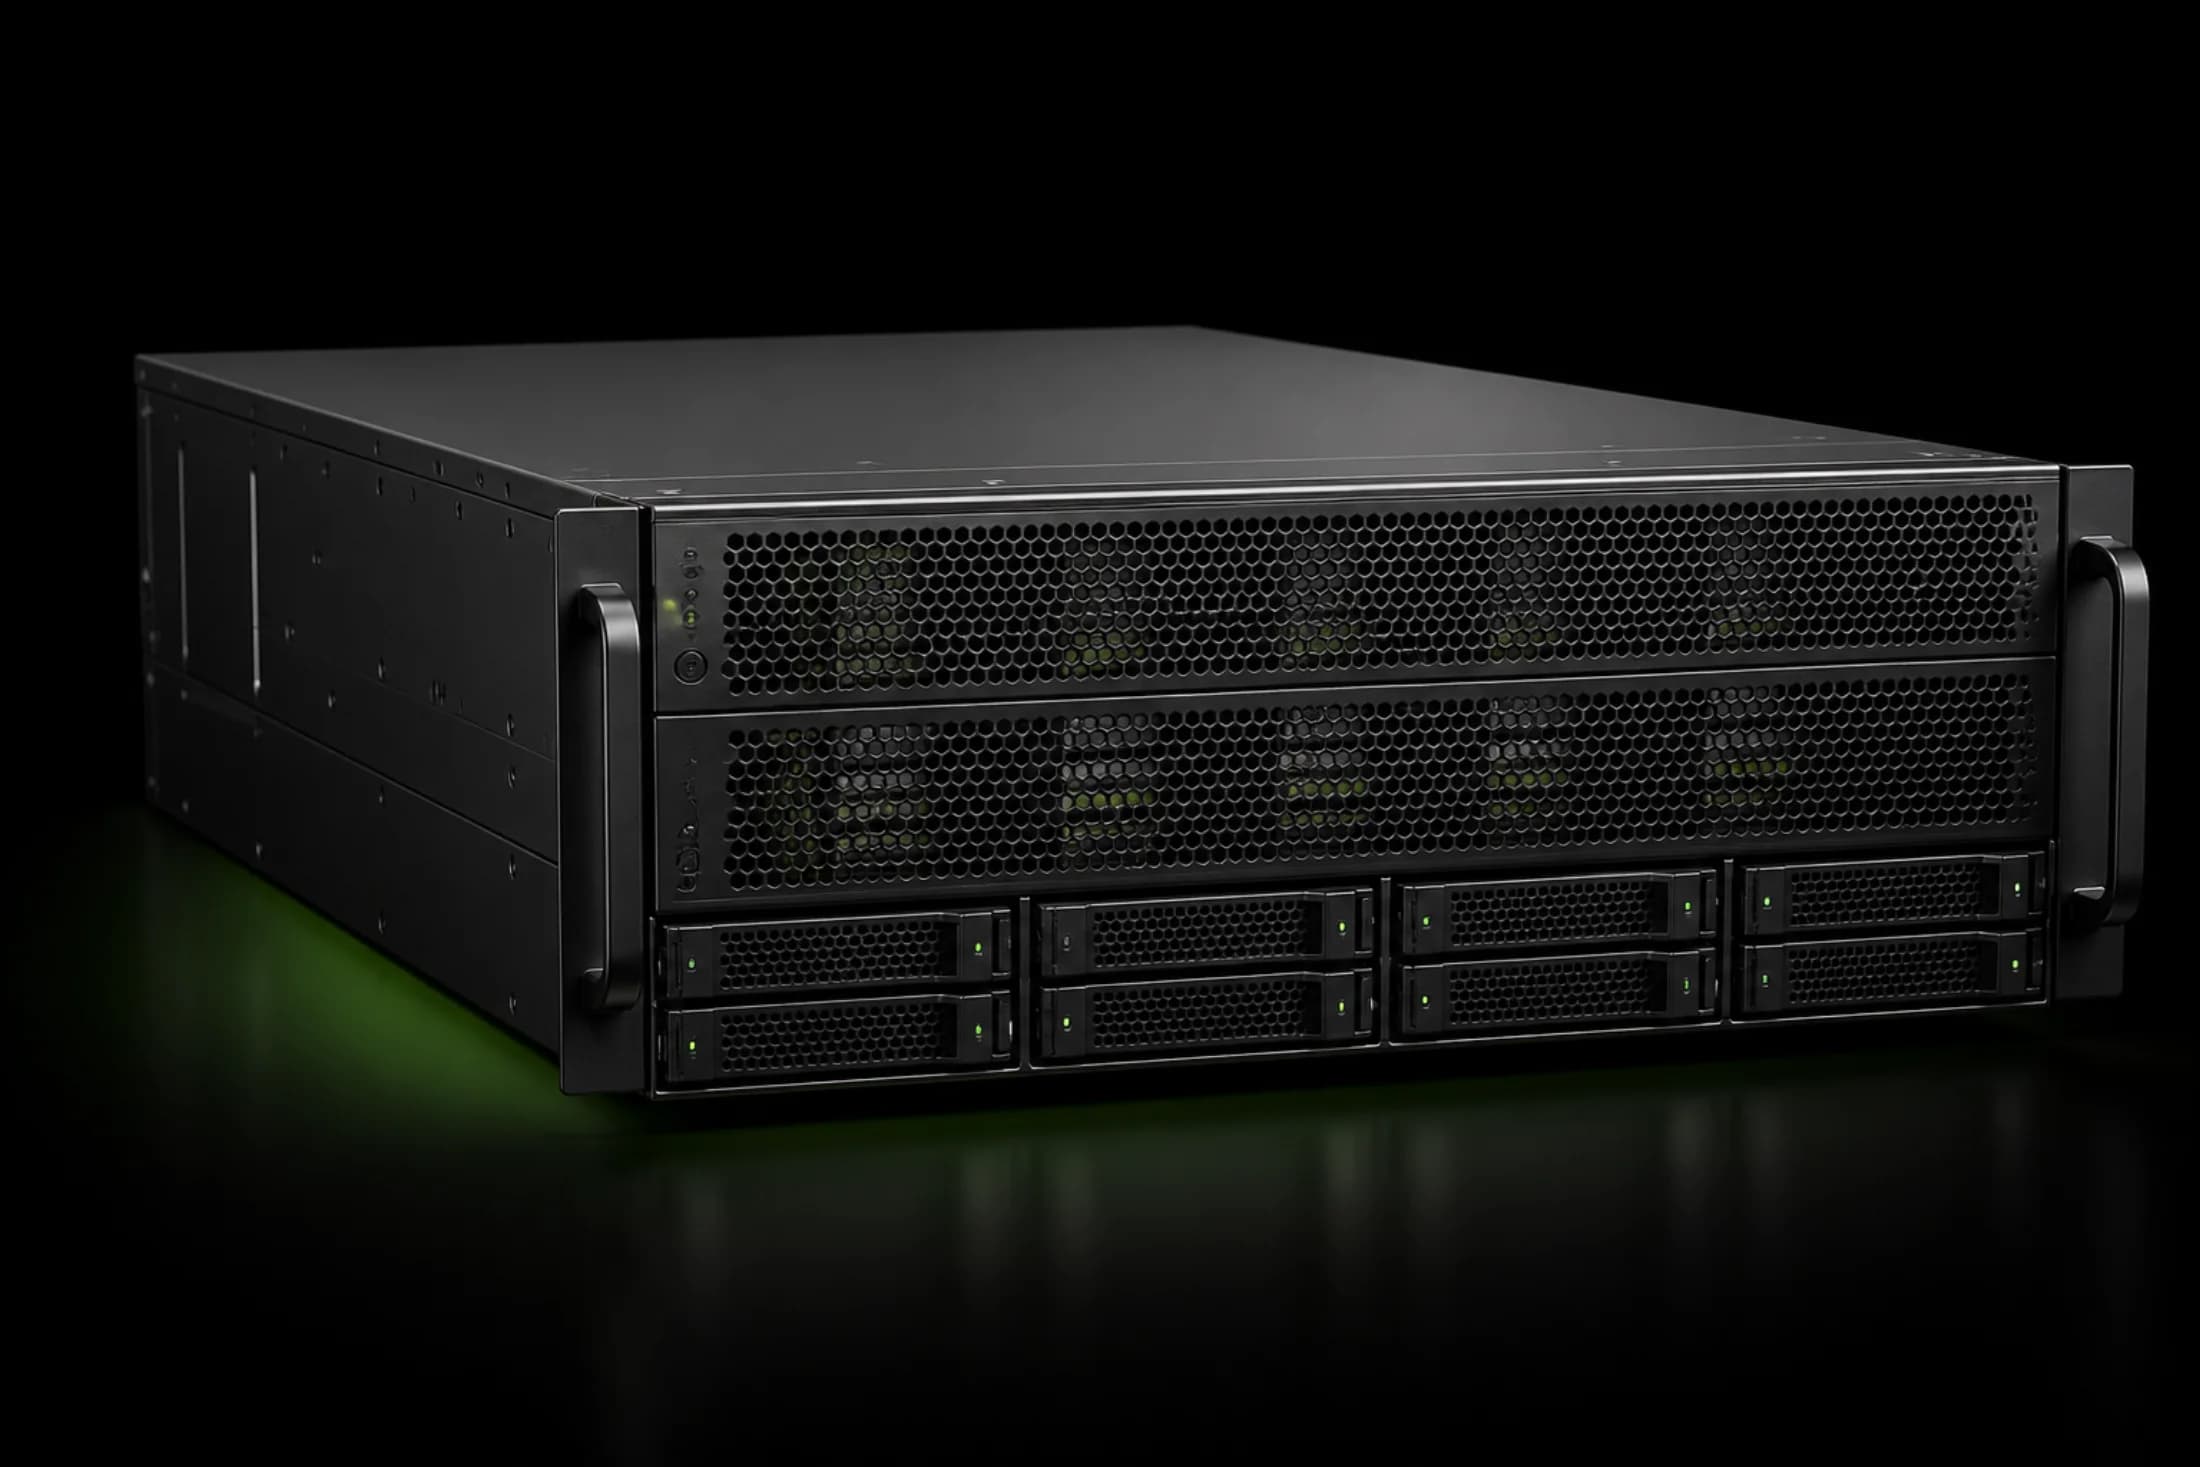
Стоечный GPU-сервер для AI-инфраструктуры
8-GPU SYSTEMHGX PLATFORM
Подборпод workload
Поставкаварианты платформ
Интеграцияв контур ЦОД
Поддержкаусловия по проекту

GPU COMPUTE

Серверы NVIDIA для AI и HPC

Платформы для обучения моделей, production inference и высокопроизводительных вычислений.

BLACKWELLКОНФИГУРАЦИЯ ПОД ПРОЕКТ
Стоечный сервер на базе NVIDIA B200

B200 / 8-GPU HGX

NVIDIA B200

Платформа Blackwell для обучения LLM, fine-tuning, GenAI и производительного enterprise inference.

GPU8 × B200 SXM
GPU Memory1,44 TB
NetworkIB / Ethernet
Form Factor4U–8U
СтоимостьЦена по запросу
HOPPERКОНФИГУРАЦИЯ ПОД ПРОЕКТ
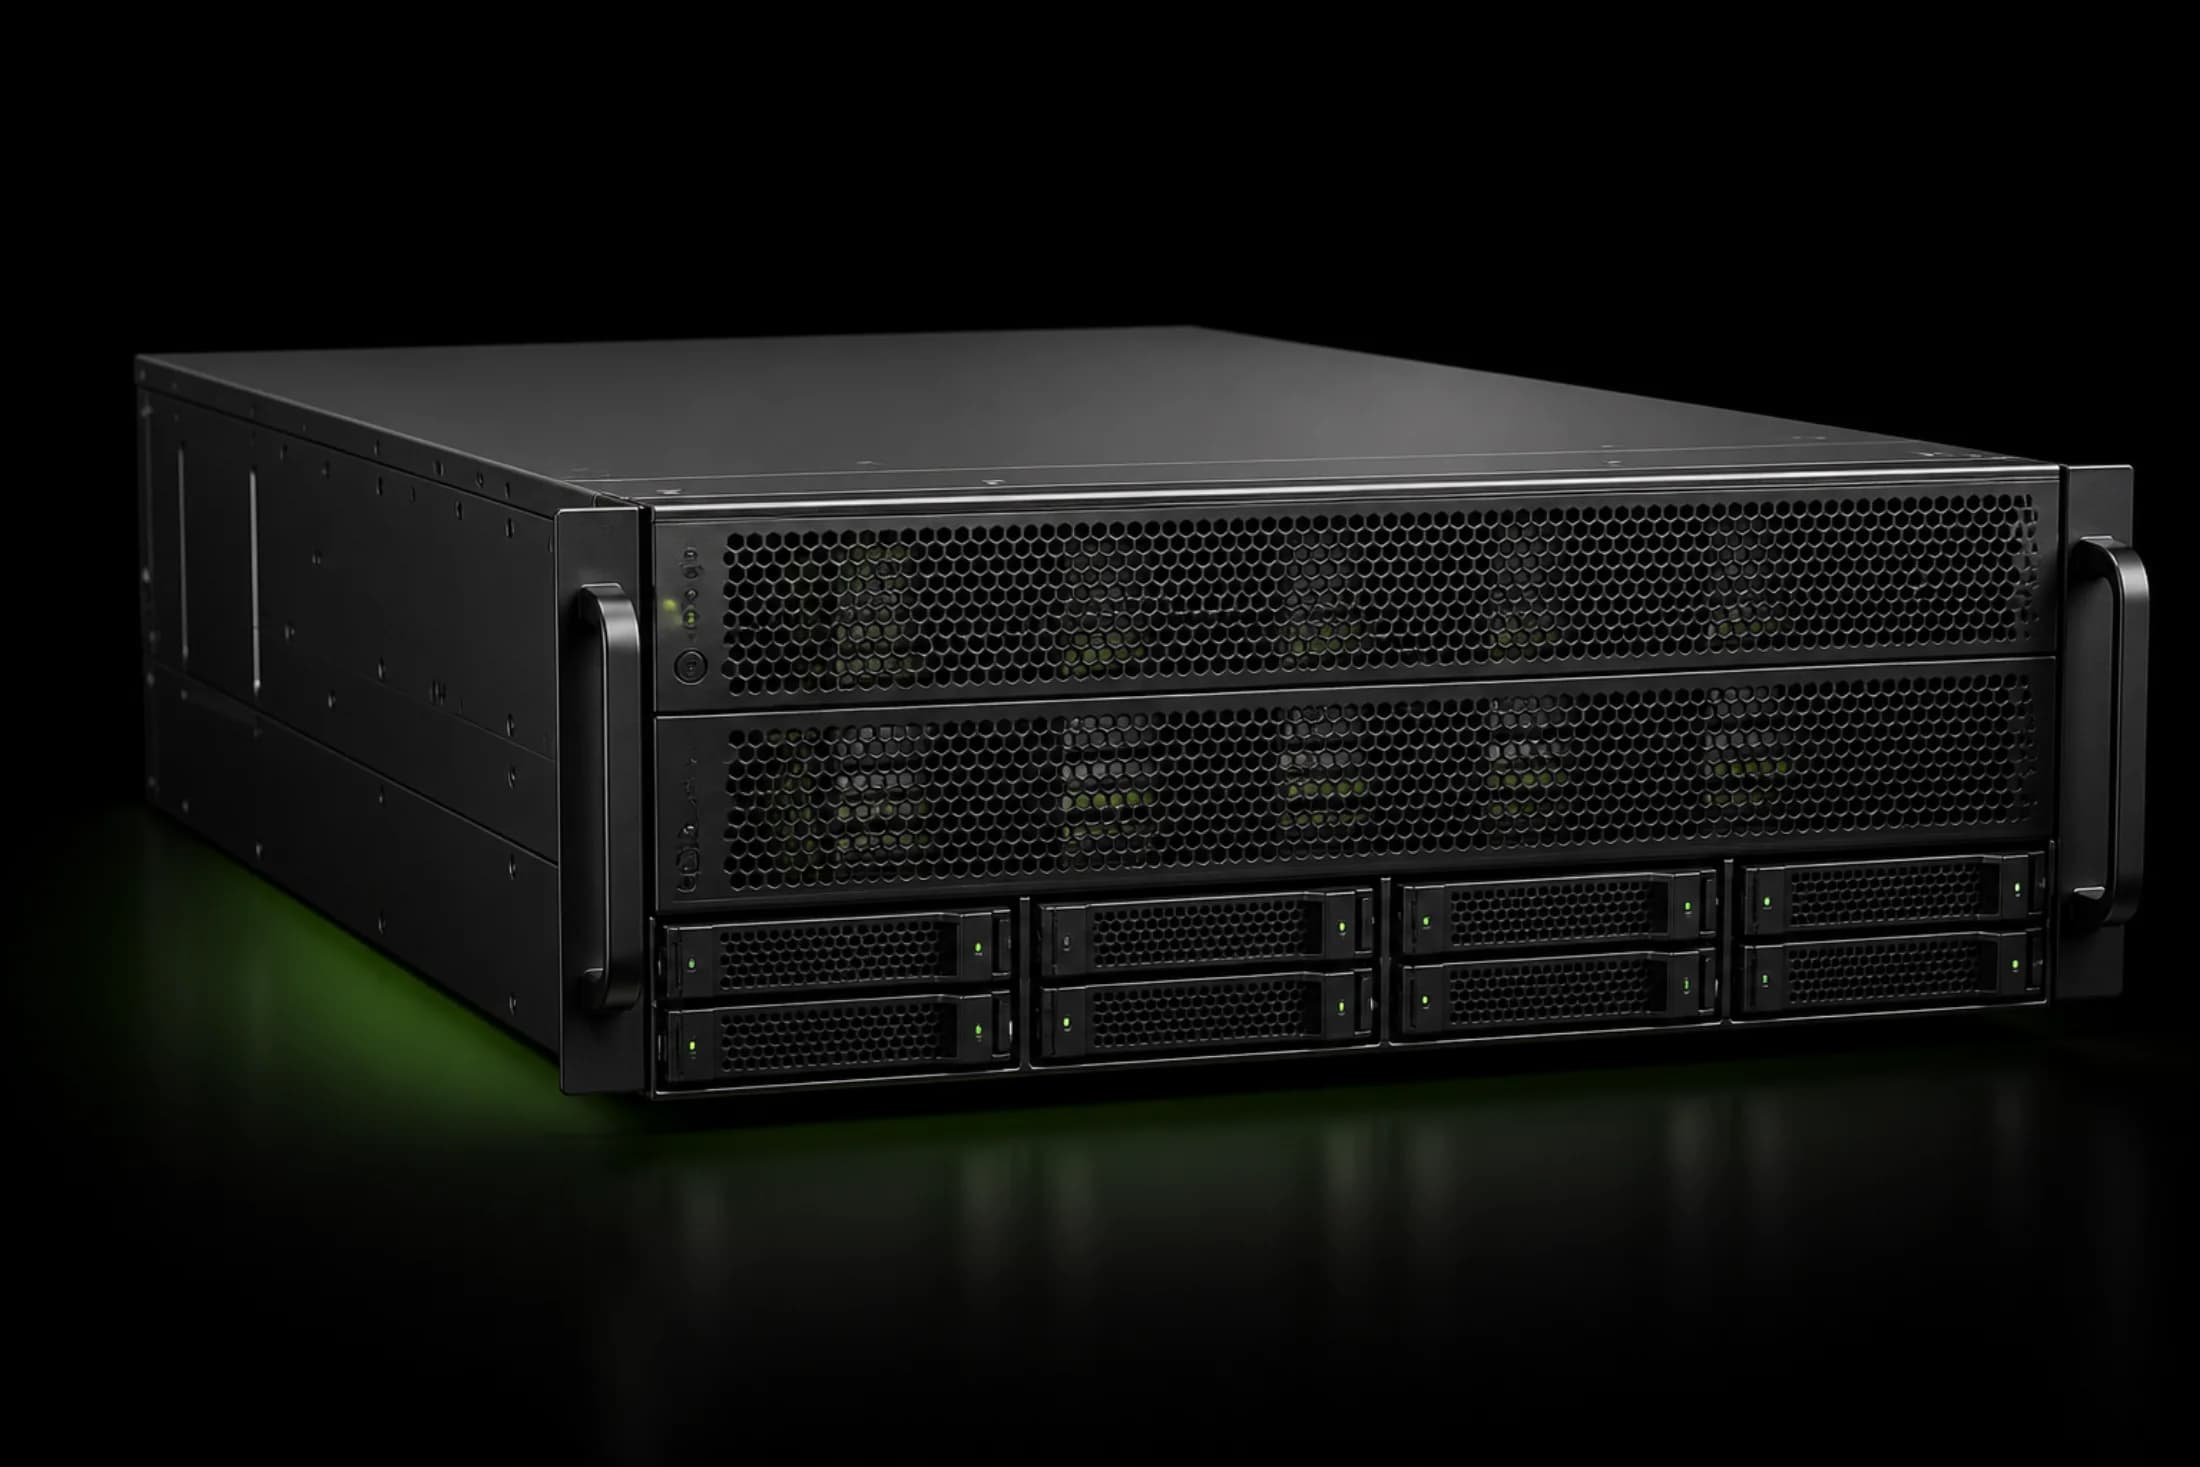
Стоечный сервер на базе NVIDIA H200

H200 / 8-GPU HGX

NVIDIA H200

Hopper-платформа с увеличенной HBM3e-памятью для LLM, production inference и HPC.

GPU8 × H200 SXM
GPU Memory≈ 1,1 TB
NetworkIB / Ethernet
Form Factor4U–8U
СтоимостьЦена по запросу
HOPPERКОНФИГУРАЦИЯ ПОД ПРОЕКТ
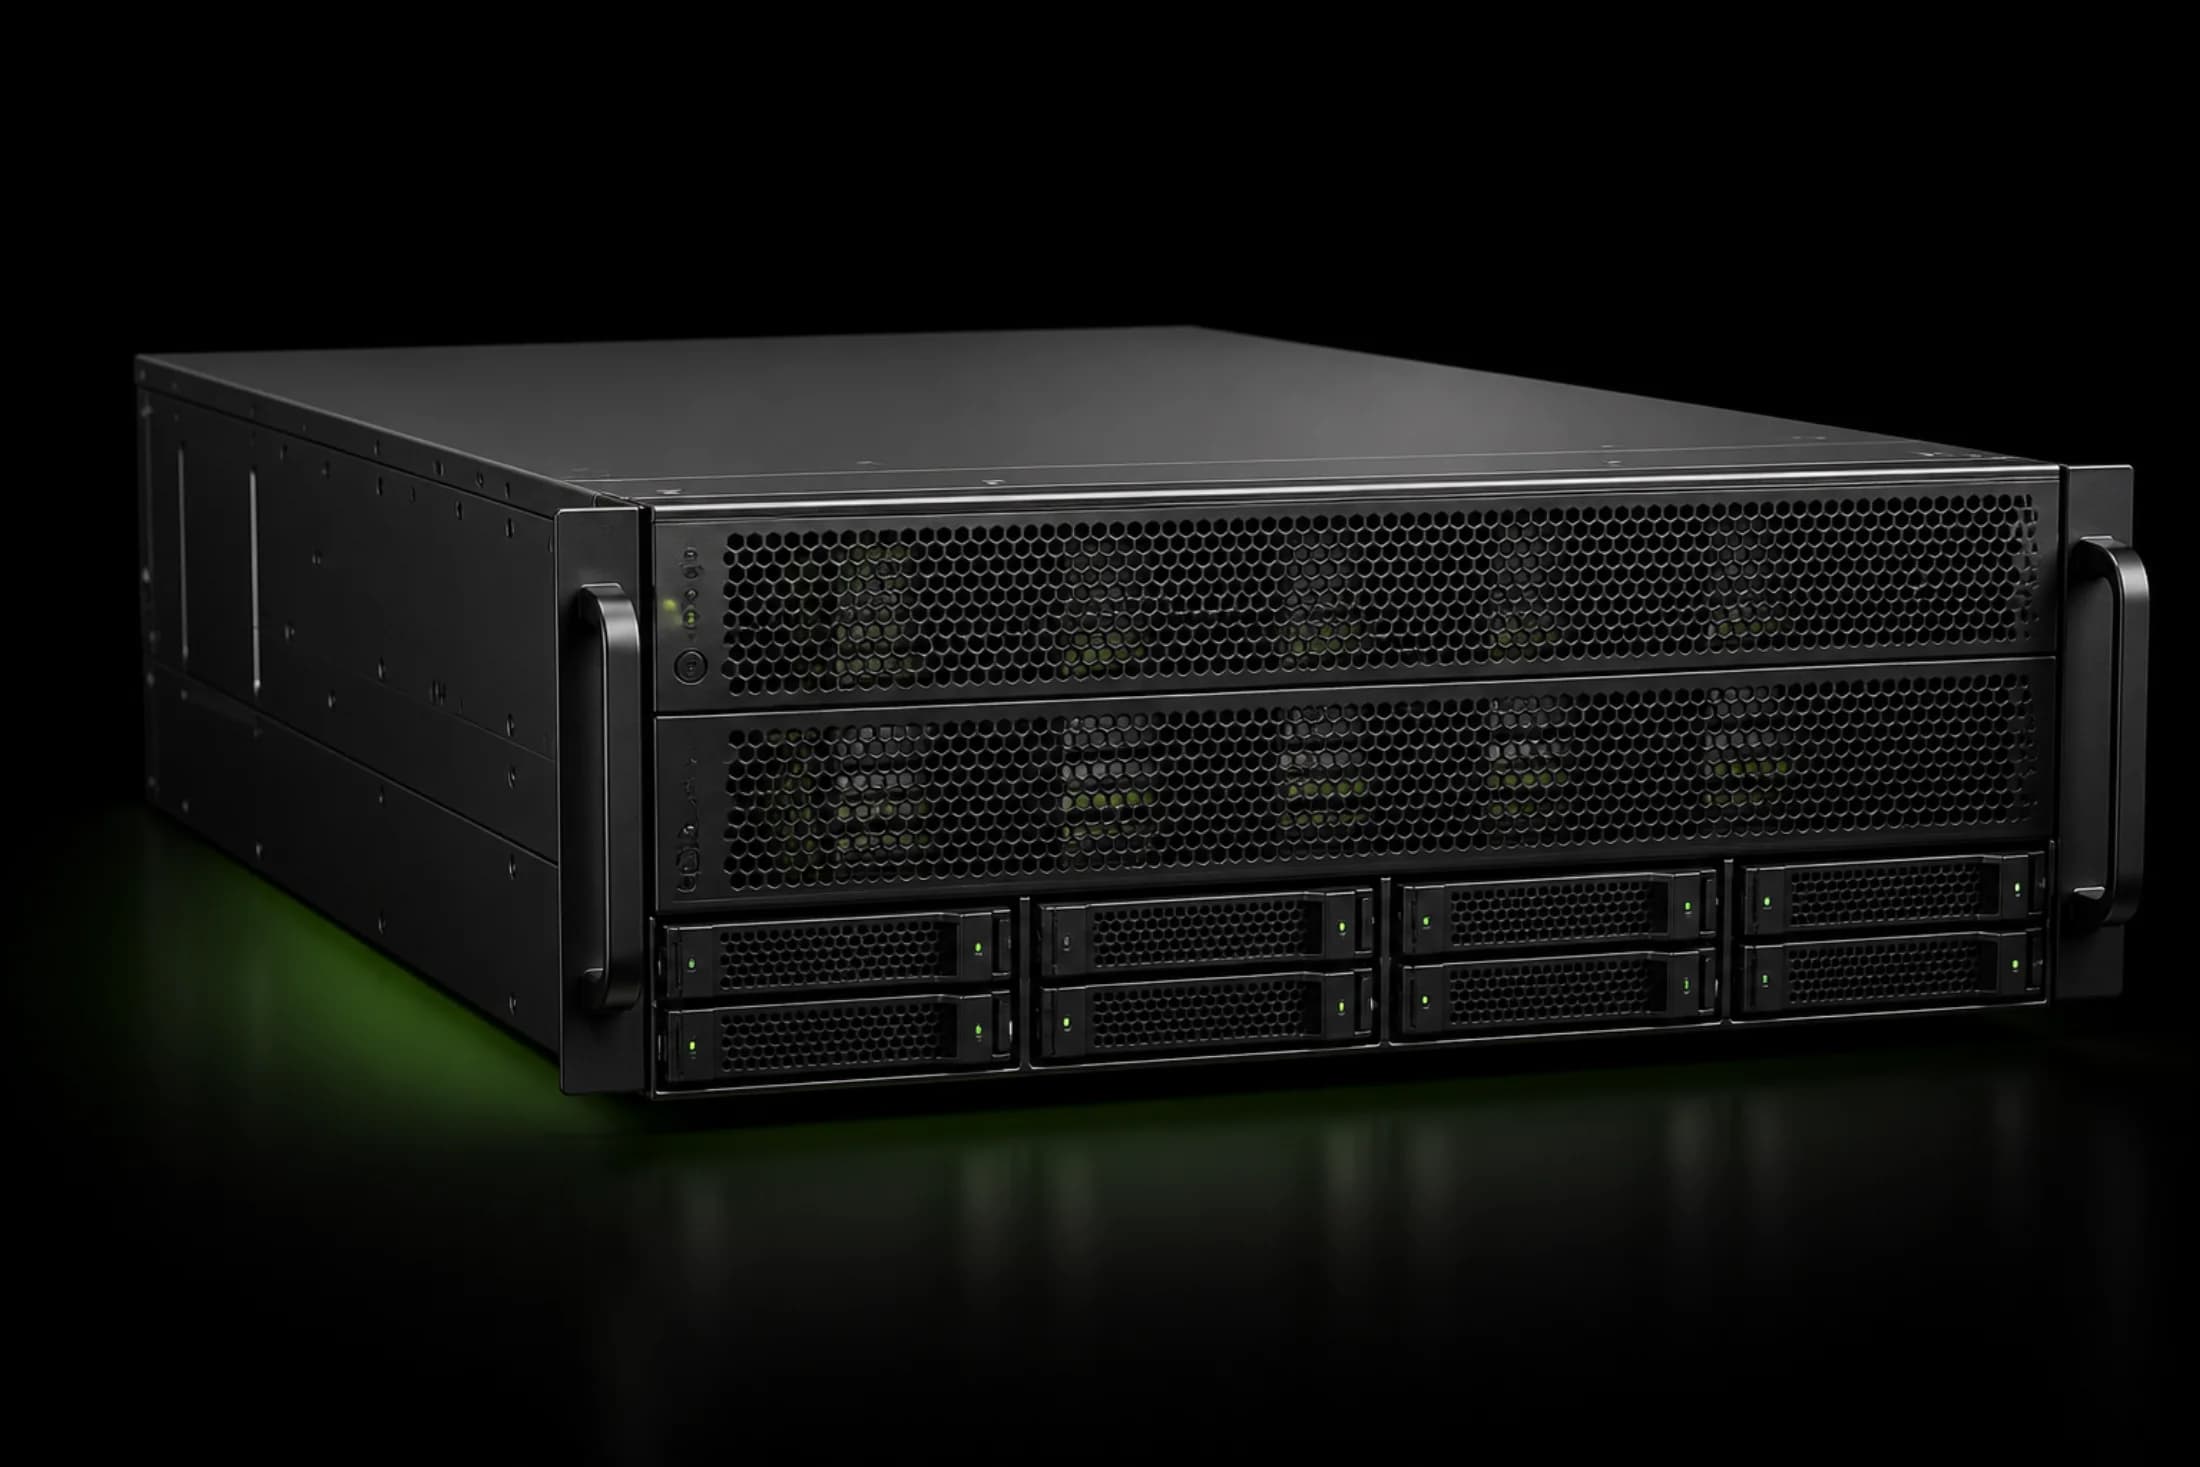
Стоечный сервер на базе NVIDIA H100

H100 / 8-GPU HGX

NVIDIA H100

Зрелая production-платформа для обучения, inference, HPC и корпоративных AI-систем.

GPU8 × H100 SXM
GPU Memory640 GB
NetworkIB / Ethernet
Form Factor4U–8U
СтоимостьЦена по запросу
PLATFORM MATRIX

Сравнение NVIDIA B300, B200, H200 и H100

Ключевые параметры 8-GPU платформ. Финальная система подбирается с учётом workload и инфраструктуры.

ПараметрBLACKWELL ULTRAB300BLACKWELLB200HOPPERH200HOPPERH100
АрхитектураBlackwell UltraBlackwellHopperHopper
Память / GPU288 GB HBM3e180 GB HBM3e141 GB HBM3e80 GB HBM3
Память 8-GPU2,30 TB1,44 TB≈ 1,1 TB640 GB
Bandwidth / GPUдо 8 TB/s на GPUдо 8 TB/s на GPU4,8 TB/s на GPU3,35 TB/s на GPU
InterconnectNVLink / NVSwitchNVLink / NVSwitchNVLink / NVSwitchNVLink / NVSwitch
Лучше всего дляReasoning · Крупнейшие LLM · AI FactoryTraining · Fine-Tuning · GenAILLM Inference · HPC · Memory-intensiveTraining · Inference · HPC

WORKLOADS

Для каких задач

Подбираем не поколение GPU само по себе, а вычислительный контур под модель, нагрузку и режим эксплуатации.

01

Обучение LLM

Обучение и дообучение больших языковых моделей с высокой плотностью GPU-памяти.

Рекомендуемые GPUB300 / B200
02

Production inference

Предсказуемый inference-контур для сервисов с высокой нагрузкой и SLA клиента.

Рекомендуемые GPUB300 / B200 / H200
03

Generative AI

Генерация текста, изображений и мультимодальные корпоративные сценарии.

Рекомендуемые GPUB300 / B200
04

RAG

Векторный поиск, reranking и генерация с доступом к корпоративным данным.

Рекомендуемые GPUH200 / H100 / B200
05

Computer Vision

Обучение и inference моделей распознавания, сегментации и видеоаналитики.

Рекомендуемые GPUH100 / H200 / B200
06

HPC

Научные и инженерные расчёты с масштабированием на несколько узлов.

Рекомендуемые GPUH100 / H200 / B200

END-TO-END AI INFRASTRUCTURE

Не только сервер.
Вся AI-инфраструктура.

Проектируем вычислительный контур целиком: от GPU до сети, СХД, питания и охлаждения.

Спроектировать инфраструктуру
01

COMPUTE

GPU-контур

  • B300
  • B200
  • H200
  • H100
02

NETWORK

Высокоскоростная фабрика

  • InfiniBand
  • Ethernet
  • ConnectX / BlueField
  • 400G / 800G
03

STORAGE

Данные без узких мест

  • NVMe
  • Dataset storage
  • Checkpoint storage
  • High-throughput I/O
04

DATA CENTER

Готовность площадки

  • Rack / PDU
  • Power
  • Air / DLC
  • Monitoring

ENGINEERING FIRST

Инфраструктура под задачу,
а не сервер из каталога.

01

Инженерный подбор

Подбираем GPU, CPU, RAM, network и storage под workload.

02

Поставка

Формируем варианты доступных серверных платформ без привязки к одному шасси.

03

Интеграция

Проектируем серверную, сетевую архитектуру и контур хранения данных.

04

Масштабирование

От одной 8-GPU системы до кластера с межузловой фабрикой.

Оборудование ведущих производителей

NVIDIASUPERMICRODell TechnologiesHPELenovoGIGABYTEASUS
Состав поставки зависит от выбранной конфигурации и доступности оборудования.

PROJECT FLOW

От задачи до готовой инфраструктуры

Один инженерный контур — от первичного расчёта до интеграции системы.

01

Задача

Получаем информацию о модели, нагрузке, пользователях и ограничениях ЦОД.

02

Конфигурация

Подбираем GPU, CPU, RAM, storage, network и серверную платформу.

03

Коммерческое предложение

Формируем варианты решения и фиксируем состав каждой конфигурации.

04

Поставка и запуск

Согласуем поставку, монтаж и интеграцию в инфраструктуру клиента.

REQUEST FOR PROPOSAL

Подберём GPU-сервер под вашу задачу

Опишите workload — предложим конфигурацию на B300, B200, H200 или H100 и учтём требования к сети, СХД и ЦОД.

01 Без фиксированной конфигурации02 Расчёт инфраструктуры целиком03 КП под ваш проект
Получить КП